
流式输出
让模型开始动手。流式输出,边读边运行配套 Python 代码。
1. 故事:让 AI 像打字一样回答
ch03 的 agent 每次说话都是"憋很久 → 一次性整段吐出"。如果 AI 要写 200 字的解释,你得干等三五秒才能看到。体验很糟。
ChatGPT、DeepSeek 网页版的体验就好得多——文字一个字一个字地跳出来,你几乎没有等待感。这叫流式输出(streaming)。
技术上 stream=True 让 OpenAI SDK 返回一个生成器(你 for 一次拿一小段),不是一个完整的 response 对象。
但是流式有一个地狱级的复杂点:当模型要调工具时,tool_calls 字段也是分块传过来的——每片只有 index + id + name + arguments 的一部分,你必须按 index 自己拼装。生产级实现要写 60+ 行 dict 合并代码。
为了让本章在 270 行内可读,我们做了一个明确的简化:
流式只用于"模型输出最终文本"的回合。 如果检测到模型要调工具,放弃流式,改用 ch03 的非流式方式重新请求一次。
代价:触发工具调用的回合会"卡一下"。完整版 在 APPENDIX_full_streaming.py,不在主线讲解——它就是给你看看"工业级" 长什么样,跑通本章后再读它。
2. 跑起来
cd ch04_stream
python main.py
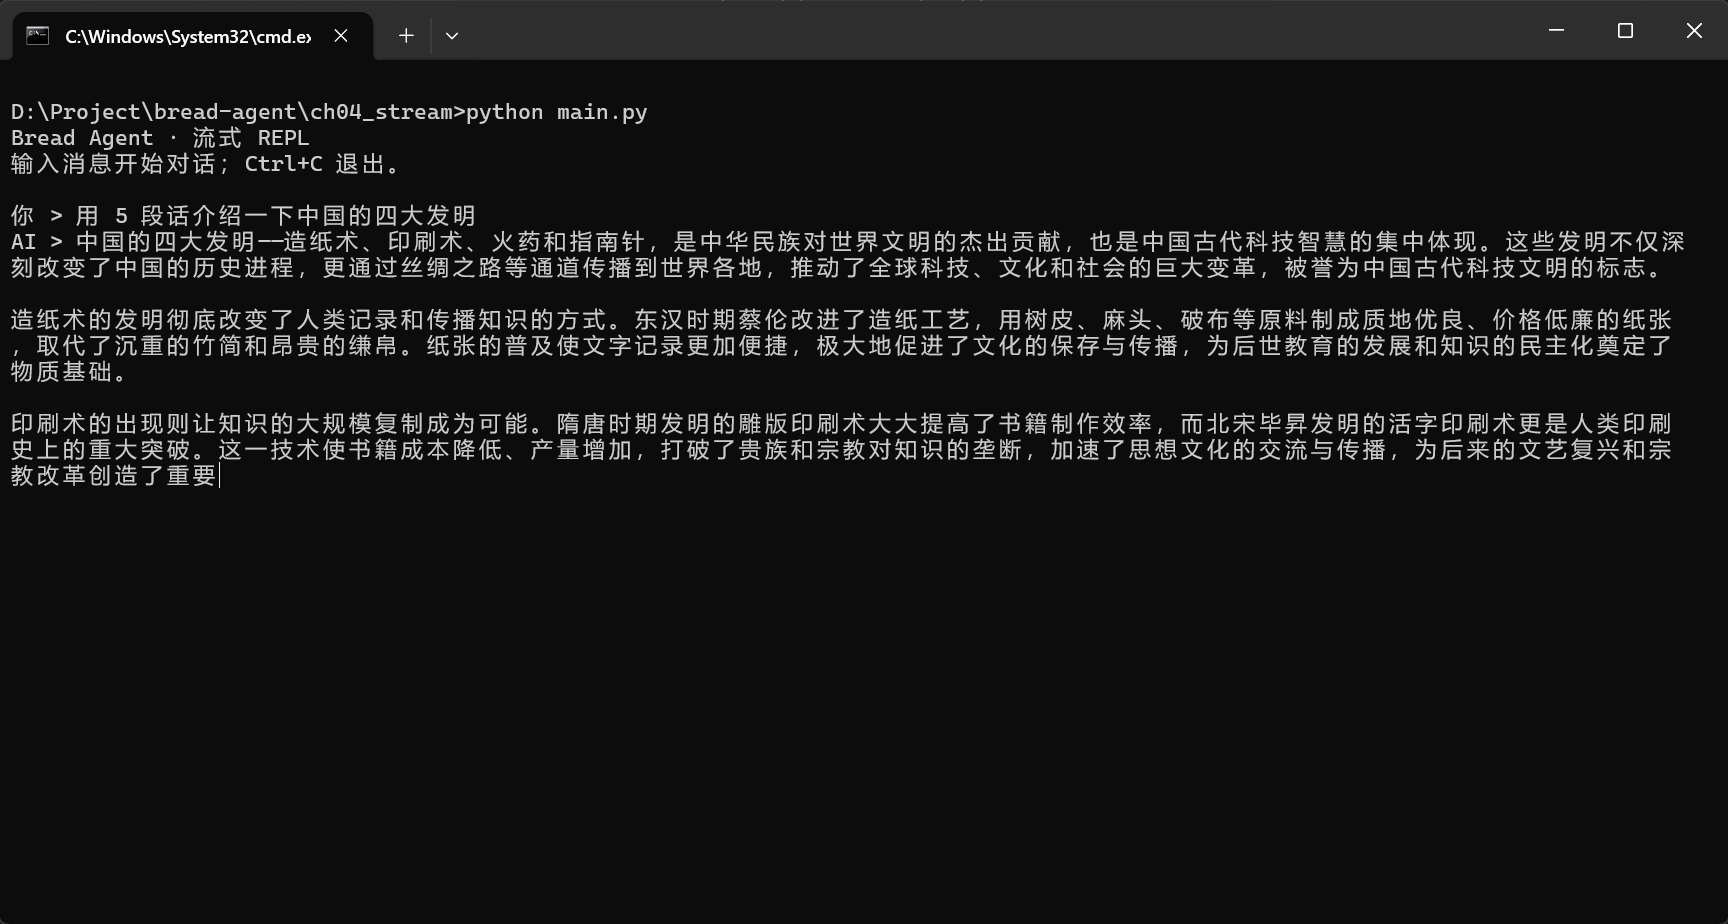
先让 AI 写一段长回答(不会触发工具):
你 > 用 5 段话介绍一下中国的四大发明
AI > 中国的四大发明——造纸术、印刷术、火药和指南针,是中华民族对世界文明的杰出贡献...
        ↑↑↑ 这些字应该是一个一个蹦出来的(流式)
再让它做一个会调工具的回合:
你 > 列出当前目录都有什么
AI > [切换到非流式模式获取工具调用...]
  [tool] list_dir({'path': '.'})
AI > 当前目录有 ... 等文件。
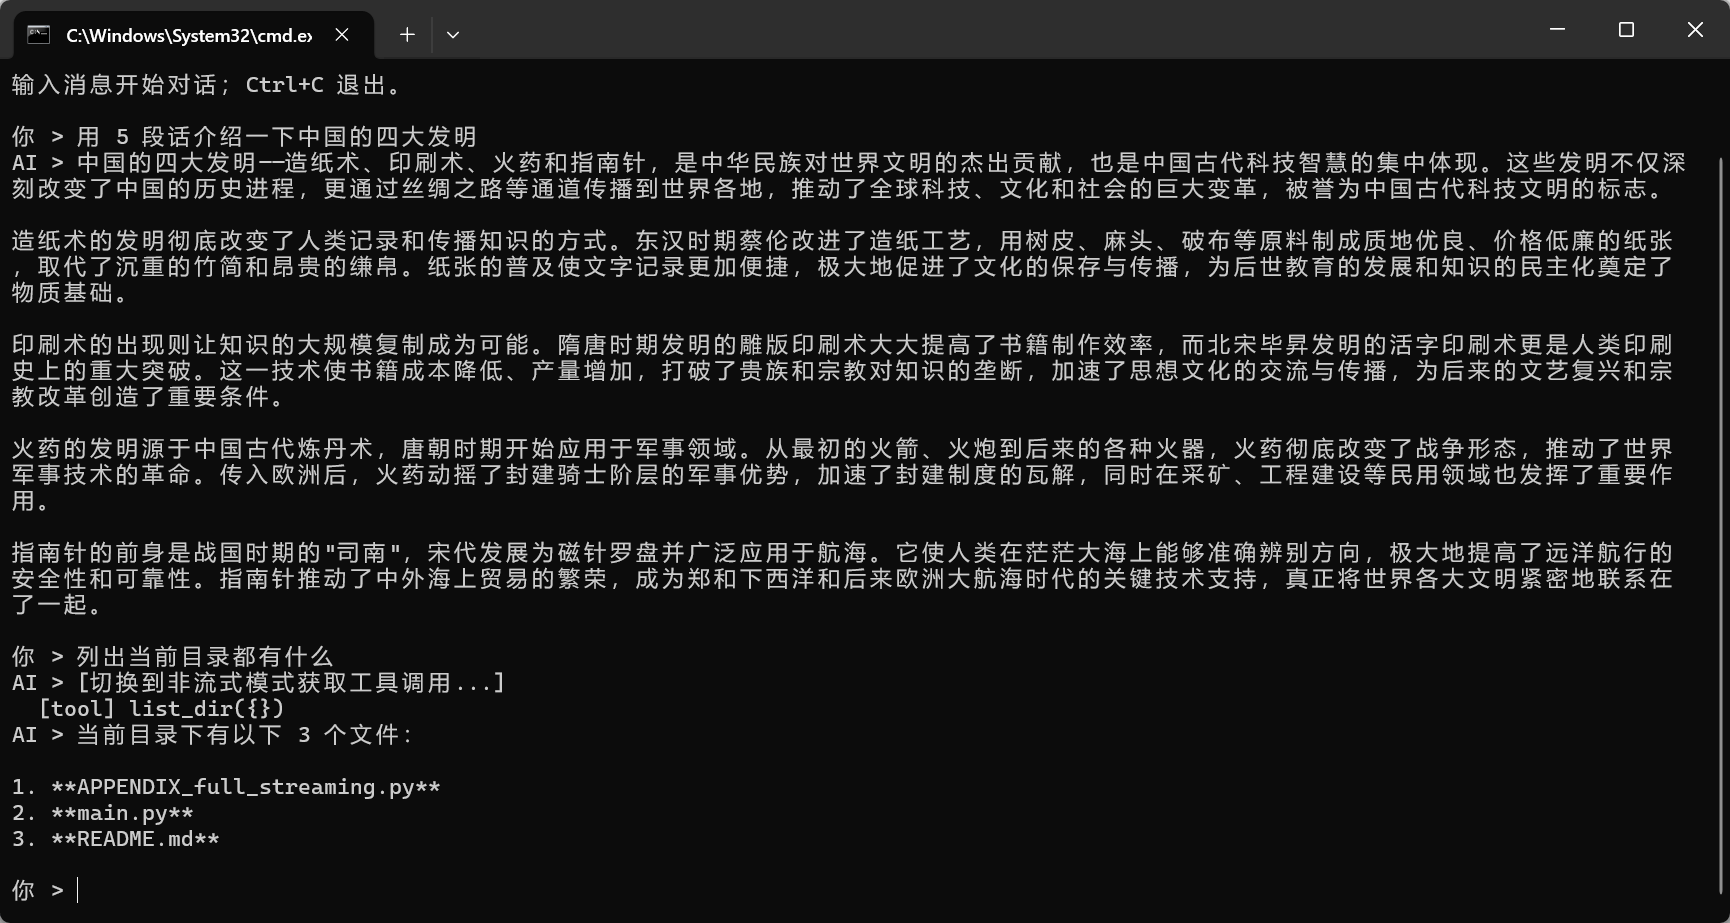
注意 [切换到非流式模式获取工具调用...] 这行——这就是我们的简化在工作:遇到工具调用就回退非流式。
3. 逐行精讲
核心函数:stream_one_turn
def stream_one_turn(messages: list) -> tuple[str, bool]:
    stream = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        tools=TOOLS_SCHEMA,
        stream=True,   # ← 关键开关
    )

    accumulated_text = ""
    detected_tool_call = False

    for chunk in stream:
        if not chunk.choices:
            continue
        delta = chunk.choices[0].delta

        # ★ 工具调用检测
        if delta.tool_calls:
            detected_tool_call = True
            for _ in stream:    # 把流剩下的部分消费掉
                pass
            break

        # ★ 文本 delta
        if delta.content:
            print(delta.content, end="", flush=True)
            accumulated_text += delta.content

    if accumulated_text:
        print()
    return accumulated_text, detected_tool_call
仔细看 3 个关键点:
for chunk in stream:流式响应是个生成器,每个 chunk 是模型生成的"一片"delta.content:当前 chunk 的文本片段(可能是几个字或一个标点)。print(end="", flush=True)立即打到屏幕不换行if delta.tool_calls:一旦发现任何片里有tool_calls,立即设标志位、把流剩余部分消费掉(不消费的话连接会一直挂着),然后 break
返回 (accumulated_text, detected_tool_call)——告诉外层"这次流到底是个纯文本回答还是个工具请求"。
print(..., end="", flush=True) 的细节
end="":默认print会在末尾加换行\n,这里不想换flush=True:默认 print 会把字符缓冲到一定量才真打到屏幕,这里强制立即刷新
少了 flush=True,你看到的体验就不是"逐字"而是"逐句/逐段",丑很多。
外层逻辑:run_turn
def run_turn(messages: list):
    for step in range(MAX_STEPS):
        print("AI > ", end="", flush=True)

        text, has_tool = stream_one_turn(messages)

        if not has_tool:
            messages.append({"role": "assistant", "content": text})
            return     # 纯文本回答,已经流式打印过了,结束

        # 检测到要调工具,回退非流式拿完整 tool_calls
        print("[切换到非流式模式获取工具调用...]")
        assistant_msg = non_stream_one_turn(messages)
        messages.append(assistant_msg)

        if not assistant_msg.tool_calls:
            print(assistant_msg.content or "")
            return

        for call in assistant_msg.tool_calls:
            # ... 执行工具,跟 ch02/ch03 一样
工具调用的回合长这样:
- 先用流式请求一次
- 检测到
tool_calls,扔掉这次响应(已经流出来的文本也丢掉) - 用非流式重新请求一次,拿完整的 tool_calls
- 后续工具执行 + 循环跟 ch03 完全一样
代价:这一回合用了 2 次 LLM 调用(流式那次的钱白花了)。但代码极其清楚——这只是教学的取舍,实际上不要这么干!
附录 APPENDIX_full_streaming.py
你不需要为本章学会这个文件。它演示"工业级"做法——拼装 tool_calls 的 delta:
tool_calls_by_index: dict[int, dict] = {}

for chunk in stream:
    for tc_delta in chunk.choices[0].delta.tool_calls or []:
        idx = tc_delta.index
        if idx not in tool_calls_by_index:
            tool_calls_by_index[idx] = {"id": "", "function": {"name": "", "arguments": ""}}
        slot = tool_calls_by_index[idx]
        if tc_delta.id:
            slot["id"] += tc_delta.id
        if tc_delta.function.name:
            slot["function"]["name"] += tc_delta.function.name
        if tc_delta.function.arguments:
            slot["function"]["arguments"] += tc_delta.function.arguments
读懂这段差不多就读懂 pi agent的流式部分了。但不必现在硬啃——等你跑完整门课,再回头看就轻松。
4. 卡住了怎么办
❌ 文字不是逐字蹦出,而是整段一次性出
99% 是 print 漏了 flush=True,或者 end="" 漏了。再检查一遍:
print(delta.content, end="", flush=True)
❌ 工具调用回合卡了几秒才看到 [切换到非流式模式...]
正常。因为我们要先把流读完才能确认有 tool_calls。如果模型立刻输出 tool_calls,这个延迟就很短;如果模型先输出一些文本再 tool_calls,等待会长一点。这是我们简化方案的代价。
❌ 流式时按 Ctrl+C 终端卡住
KeyboardInterrupt 在 for chunk in stream 里 raise 时,OpenAI SDK 应该会自动关闭连接。如果遇到卡住,可能是 SDK 版本问题。重启 Python 进程即可。
❌ 试附录 APPENDIX_full_streaming.py 跑
附录文件不是独立可跑的,它只给函数定义。要试,你需要:
- 把
stream_with_tool_call_assembly函数复制到main.py - 修改
run_turn调它替换原有的stream_one_turn - 修改
messages.append时处理 tool_calls 是 list of dict 的形态
这是高难度题,pi-main 在 agent-loop.ts:275-368 有完整工业级实现可对照。
5. 思考题
题 1:延迟对比
把 stream=True 这一行临时改成 stream=False,再问"写一首 8 句的诗"。对比两次的"首字延迟"体感。
理解:流式不缩短总时长,但极大提升首字响应速度——这就是好 UX 和差 UX 的区别。
题 2:彩色输出
在打印 AI 内容前后包 ANSI 转义码:
print("\x1b[36m" + delta.content + "\x1b[0m", end="", flush=True)
\x1b[36m 是青色,\x1b[0m 是重置。你应该看到 AI 的字全部变色。Windows Terminal、PowerShell 7+、所有 macOS/Linux 终端都支持。
题 3:挑战附录
读懂 APPENDIX_full_streaming.py,把它接到 main.py 里替换简化版。如果跑通了,你已经掌握 pi-main 流式实现的 80%。
这一章你学会了什么
- ✅
stream=True让 LLM 响应变成生成器 - ✅
print(end="", flush=True)让字"立刻打"到屏幕 - ✅ 本章主动简化:tool_calls 不做 delta 拼装,回退非流式
- ✅ 工业级流式(附录):按
index累积 tool_calls 的 id/name/arguments
下一章 ch05:第一次重构——把堆在 main.py 的代码拆成 agent.py / tools.py / main.py 三个模块,并引入动态系统提示词。这是工程化第一步。